什麼是 LLM?大型語言模型完整概念解析|Token、參數、微調、RAG 一次搞懂
📥 工作流 JSON 下載:GitHub 範例庫 | 💬 社群討論:Skool AI Brain
專業導讀#
你有沒有遇過這種情況?打開 ChatGPT 聊了半小時,覺得 AI 超厲害,但別人問你「LLM 到底是什麼?」的時候卻答不出來?或者你在設定 n8n 的 AI 節點時,看到 Token、Temperature、Model 這些參數,完全不知道怎麼選?
我自己剛接觸 AI 的時候也是一樣的狀態。後來我花了大量時間研究,才發現理解 LLM 的底層概念,對於後續建立 AI 自動化工作流真的太重要了。今天這篇文章,我會用最白話的方式帶你把 LLM 的核心概念搞清楚。
- 什麼是 LLM?用一個超簡單的類比讓你秒懂
- Token 是什麼?為什麼它決定了你的 API 費用
- 參數量、微調、RAG 這些專有名詞到底在說什麼
- 目前主流的 LLM 模型有哪些、怎麼選
- 在 n8n 自動化中如何實際運用 LLM
什麼是 LLM?#
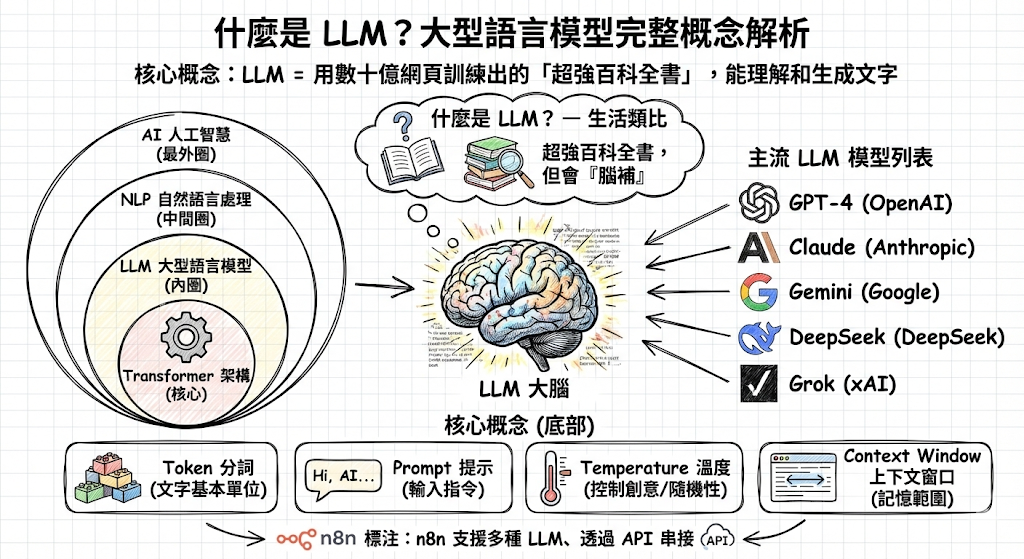
LLM(Large Language Model,大型語言模型)是一種透過海量文本資料訓練出來的 AI 模型,能夠理解人類語言、生成文字回答、甚至執行複雜的推理任務。 你每天在用的 ChatGPT、Claude、Gemini 背後都是 LLM 在運作。
讓我帶你看一下,LLM 到底是怎麼一回事。
生活化類比:超強百科全書#
想像有一本百科全書,它讀過了網路上數十億個網頁的內容,從維基百科到 Stack Overflow,從學術論文到 Reddit 討論串。這本百科全書不只是把內容記下來,它還「理解」了語言的模式跟邏輯。
所以當你問它一個問題,它不是去查資料庫找答案(這跟 Google 搜尋不一樣),而是根據它學到的語言模式,一個字一個字地「生成」回答。
這就是 LLM 的核心概念:它不是在搜尋答案,而是在生成答案。
這個區別很重要。因為這代表 LLM 有時候會「幻覺」(Hallucination)—— 就是一本正經地胡說八道。我自己實測的結果是,大約有 5-10% 的回答可能包含不準確的資訊,尤其是涉及到具體數字、日期、或者冷門知識的時候。
LLM 的基本運作原理#
簡單來說,LLM 的運作流程是這樣的:
- 輸入處理:你輸入的文字會被拆成一個個 Token(稍後會詳細解釋)
- 模式匹配:模型根據學到的語言模式,計算每個可能的下一個 Token 的機率
- 文字生成:選擇機率最高的 Token 作為輸出,然後重複這個過程
- 輸出完成:直到生成完整的回答
重點來了 —— LLM 本質上就是一個超級厲害的「下一個字預測器」。它不是真的「理解」你說的話,而是根據統計模式來生成最合理的回答。
為什麼你需要理解 LLM?#
你可能會想:「我又不是 AI 研究員,為什麼要懂這些?」
這個很重要。因為理解 LLM 的基礎概念,會直接影響你在實際應用中的效率跟成本。
1. 選對模型省大錢#
不同的 LLM 模型有不同的能力跟價格。如果你不懂差異,可能會用 GPT-4 來做一個簡單的文字分類任務,明明用 GPT-4o-mini 就能搞定,成本差了 20 倍以上。我自己在幫學員做 n8n 自動化的時候,光是選對模型這一步,就幫好幾個學員每月省了上百美元。
2. 寫出更好的 Prompt#
理解 LLM 是怎麼處理輸入的,你就會知道為什麼 Prompt 的寫法這麼重要。為什麼結構化的 Prompt 效果比較好?為什麼給範例比純文字描述有效?這些都跟 LLM 的運作原理有關。
3. 建立更強的 AI 自動化#
在 n8n 裡面,你會碰到各種 LLM 相關的設定:Temperature、Max Tokens、System Prompt 等等。不懂這些參數的意義,你的自動化工作流就只能碰運氣。懂了之後,你才能真正掌控 AI 的行為。
Alex 的實戰觀察#
我從 2024 年開始大量使用各種 LLM 來建立自動化工作流,到現在已經測試過超過 20 種不同的模型。讓我跟你分享一些實戰心得。
LLM 的能力邊界#
很多人把 LLM 想得太神,覺得它什麼都能做。我的觀察是,LLM 在以下場景表現最好:
- 文字生成與改寫:這是 LLM 的強項,準確率可以到 90% 以上
- 資料整理與分類:給它結構化的指示,效果非常穩定
- 翻譯與摘要:尤其是長文本摘要,比人工快 10 倍
但有些事情 LLM 確實不太行:
- 即時資訊查詢:LLM 有知識截止日,不知道最新的事情
- 精確計算:數學計算偶爾會出錯,尤其是複雜的算術
- 長期記憶:對話超過一定長度,前面的內容就會被「遺忘」
我覺得最重要的一點是:LLM 是工具,不是魔法。 你要把它放在對的位置,搭配對的工作流,才能發揮最大價值。在我的 n8n 自動化系統裡,我都是把 LLM 放在特定環節,而不是讓它獨立完成整個任務。
成本的真實數字#
我自己每個月在 LLM API 上的花費大約是 50-80 美元,涵蓋了內容生成、資料處理、客服自動化等多個工作流。如果你是剛開始的個人用戶,每月 10-20 美元就能處理大部分需求。不用擔心成本太高,重點是要選對模型跟控制好 Token 用量。
LLM 核心概念詳解#
接下來我要帶你認識幾個最重要的 LLM 概念。不用想太多,我會用最簡單的方式解釋。
Token:LLM 的最小單位#
Token 是 LLM 處理文字的最小單位。你可以把它想成 LLM 看到的「字」,但跟我們平常說的「字」不完全一樣。
- 英文中,一個 Token 大約等於 0.75 個英文單字("Hello world" = 2 Tokens)
- 中文中,一個中文字通常是 1-2 個 Token(「你好」= 2-3 Tokens)
- 程式碼中,符號跟關鍵字各算一個 Token
為什麼 Token 很重要?因為:
- API 費用按 Token 計算:輸入的 Token + 輸出的 Token = 你要付的錢
- 上下文長度限制:每個模型有最大 Token 限制(例如 GPT-4o 是 128K Tokens)
- 回應速度受 Token 影響:生成越多 Token,等待時間越長
參數量(Parameters)#
你可能聽過「GPT-4 有 1.8 兆個參數」這種說法。參數量基本上就是模型的「腦容量」。
- 參數越多:模型越聰明,但也越慢、越貴
- 參數越少:速度快、成本低,但能力有限
舉個例子:GPT-4o-mini 的參數量比 GPT-4o 少很多,所以它的 API 費用只有 GPT-4o 的 1/20,但在簡單任務上表現差不多。
Temperature(溫度)#
Temperature 是控制 LLM 回答「創意程度」的參數,範圍通常是 0 到 2:
- Temperature = 0:每次回答都一樣,最穩定、最可預測
- Temperature = 0.7:有一定變化,適合寫文章
- Temperature = 1.5+:非常隨機,可能會出現奇怪的回答
我在 n8n 自動化中的經驗是:大部分場景設 0 就對了。 除非你要做創意生成,否則穩定性比創意更重要。
微調(Fine-tuning)#
微調就是拿一個現有的 LLM,用你自己的資料再訓練一輪,讓它更懂你的特定領域。
想像你請了一個很聰明的新員工(LLM),他什麼都懂一點,但不了解你公司的業務。微調就是給他做入職培訓,讓他了解你公司的產品、術語、流程。
不過我要說實話,微調對大部分人來說門檻太高了。你需要準備大量的訓練資料,而且成本不低。我自己的建議是:先把 Prompt Engineering 做好,80% 的需求都能解決,真的不夠再考慮微調。
RAG(Retrieval-Augmented Generation)#
RAG 是目前最實用的 LLM 增強技術。它的概念很簡單:讓 LLM 在回答之前,先去你的知識庫裡面找相關資料,然後根據這些資料來生成回答。
為什麼需要 RAG?因為 LLM 有兩個天生的限制:
- 知識截止日(不知道最新資訊)
- 不知道你公司內部的資料
RAG 完美解決了這兩個問題。我在 n8n 裡面就建了好幾個 RAG 工作流,讓 AI Agent 能夠查詢我的課程資料、部落格文章、客戶 FAQ,然後給出準確的回答。
如果你對 RAG 有興趣,可以看我寫的 RAG 概念完整指南。
主流 LLM 模型完整比較#
2026 年初的 LLM 市場已經非常成熟,我幫你整理了目前最主流的模型比較。
綜合能力比較表#
| 模型 | 公司 | 最大 Token | 價格(每百萬 Token) | 強項 | 適合場景 |
|---|---|---|---|---|---|
| GPT-4o | OpenAI | 128K | 輸入 $2.5 / 輸出 $10 | 通用能力強、工具呼叫穩定 | 通用 AI Agent、內容生成 |
| GPT-4o-mini | OpenAI | 128K | 輸入 $0.15 / 輸出 $0.6 | 性價比極高 | 簡單分類、資料處理 |
| Claude 3.5 Sonnet | Anthropic | 200K | 輸入 $3 / 輸出 $15 | 長文本分析、推理能力強 | 複雜分析、程式碼生成 |
| Gemini 2.0 Flash | 1M | 免費 / 付費較低 | 超長上下文、多模態 | 大量文件處理、搜尋整合 | |
| DeepSeek V3 | DeepSeek | 128K | 極低(約 $0.14 / $0.28) | 中文理解優秀、開源 | 預算有限、中文場景 |
| Grok-2 | xAI | 128K | 免費額度 $150/月 | 免費額度多、即時資訊 | 新手練習、開發測試 |
我的選擇建議#
根據我自己的使用經驗,我推薦以下搭配策略:
- 新手入門:先用 xAI 的免費額度練習,不用花一毛錢
- 日常自動化:GPT-4o-mini 處理 80% 的簡單任務
- 複雜場景:Claude 3.5 Sonnet 處理需要深度推理的工作
- 大量文件:Gemini 2.0 Flash 處理超長文本(支援 100 萬 Token)
- 預算優先:DeepSeek V3 是最便宜的選擇
這邊要特別注意 —— 不是越貴的模型就越好。我自己大約 70% 的工作流都是用 GPT-4o-mini,因為它便宜又夠用。只有需要複雜推理的時候才會用到更高階的模型。
在 n8n 中使用 LLM 的實作指南#
好,再來就是最實用的部分。我來教你怎麼在 n8n 裡面設定跟使用 LLM。
步驟 1:取得 API Key#
每個 LLM 服務都需要 API Key 才能使用。以 OpenAI 為例:
- 前往 platform.openai.com
- 登入帳號,進入 API Keys 頁面
- 點選「Create new secret key」
- 複製並保存好你的 API Key
步驟 2:在 n8n 設定 Credentials#
- 在 n8n 左側選單找到 Credentials
- 點選 Add Credential
- 搜尋對應的服務(如 OpenAI、Anthropic)
- 貼上你的 API Key
- 測試連線確認可用
步驟 3:加入 AI 節點到工作流#
n8n 提供了多種 AI 相關節點:
- AI Agent:最強大的節點,支援工具呼叫、記憶、多步推理
- Chat Model:基本的對話模型節點
- Text Classifier:文字分類專用
- Summarization Chain:自動摘要
步驟 4:設定關鍵參數#
這是很多人會搞錯的地方。讓我帶你看一下最重要的幾個參數:
- Model:選擇你要用的模型(建議從 GPT-4o-mini 開始)
- Temperature:設為 0(除非做創意生成)
- Max Tokens:限制回答長度,避免浪費(一般設 1000-2000)
- System Prompt:給 AI 的角色設定,這個非常影響輸出品質
步驟 5:測試與優化#
- 用少量測試資料先跑一次
- 檢查輸出品質是否符合預期
- 調整 System Prompt 或參數
- 確認費用在可接受範圍
- 正式上線
我的經驗是,一個 LLM 工作流通常要反覆測試 5-10 次才能調到滿意。不用擔心,一步一步來,每個高手都是從新手開始的。
更多 n8n AI 自動化的教學,可以參考我的 n8n 完整教學指南。
LLM 的常見應用場景#
為了讓你更清楚 LLM 能做什麼,我整理了幾個我自己在用的實際場景。
場景 1:自動客服回覆#
用 n8n 的 AI Agent 節點搭配 RAG,讓 AI 自動回答客戶問題。我自己的系統能處理大約 60% 的客服詢問,剩下 40% 才需要人工介入。
場景 2:內容生成與改寫#
把 YouTube 影片的字幕轉成部落格文章、社群貼文、電子報。這個工作流我每週都在用,一篇影片可以自動衍生出 5-8 種不同格式的內容。
場景 3:資料擷取與整理#
從非結構化的文字中擷取結構化資料。比如把一堆客戶回饋的文字,自動分類成正面/負面/建議,然後整理成表格。
場景 4:翻譯工作流#
我有一個 字幕翻譯工作流,用 LLM 把中文字幕翻譯成英文。比起傳統翻譯工具,LLM 翻譯的語意更自然,而且可以針對特定領域做優化。
重點整理#
- LLM 是語言生成模型,不是搜尋引擎 —— 它「生成」答案而非「查找」答案
- Token 是 LLM 的計費單位,理解 Token 才能控制成本
- 參數量決定模型能力,但不是越大越好,要看場景選擇
- Temperature 控制創意程度,自動化場景建議設為 0
- RAG 是最實用的增強技術,讓 LLM 能查詢你的私有資料
- 微調門檻高,先把 Prompt Engineering 做好再考慮
- 選模型看場景,70% 的任務用便宜模型就夠了
- LLM 有明確的限制,不要期望它什麼都能做到完美
常見問題 FAQ#
LLM 和 AI 有什麼關係?#
LLM 是 AI 的一個子類別,專門處理語言相關的任務。 AI 是一個大的概念,底下有機器學習(ML)、深度學習(DL)等分支,而 LLM 屬於深度學習中的自然語言處理(NLP)領域。你平常用的 ChatGPT、Claude 都是 LLM 的應用產品。簡單記一個公式:AI > ML > DL > NLP > LLM。
LLM 會取代程式設計師嗎?#
不會完全取代,但會大幅改變工作方式。我的觀察是:
- LLM 已經能寫出 70-80% 品質的程式碼
- 但架構設計、需求分析、除錯思路仍然需要人類
- 會用 LLM 的程式設計師效率提升 2-3 倍
- 不會用 LLM 的程式設計師在效率上會越來越吃虧
我自己就是用 Claude 來寫大部分的 Python 腳本跟 n8n 工作流,效率確實提升了很多。但關鍵的架構決策還是我自己做的。
如何選擇適合的 LLM 模型?#
根據你的需求來選:
- 通用任務、預算充足:GPT-4o
- 長文分析、複雜推理:Claude 3.5 Sonnet
- 超長文件處理:Gemini 2.0 Flash(100 萬 Token 上下文)
- 預算有限:DeepSeek V3(價格最低)
- 新手練習:xAI Grok(每月 $150 免費額度)
- 簡單任務、大量處理:GPT-4o-mini(性價比之王)
如果你不確定,就從 GPT-4o-mini 開始,不夠再升級。
LLM 的幻覺問題要怎麼處理?#
幻覺(Hallucination)是指 LLM 會一本正經地編造不存在的資訊。處理方式:
- 用 RAG 提供事實來源:讓 LLM 根據你的資料回答,而不是靠「記憶」
- 降低 Temperature:設為 0 可以大幅減少幻覺
- 在 Prompt 中要求引用來源:強制 LLM 標註資訊出處
- 加入驗證步驟:重要資訊用另一個 LLM 或工具做交叉驗證
- 限定回答範圍:在 System Prompt 中明確告訴 LLM「如果不確定就說不知道」
我在自己的 AI Agent 工作流中,一定會加入 RAG 和驗證步驟。這樣幻覺率可以從 10% 降到 2% 以下。
Token 費用怎麼估算?#
一個簡單的估算方法:
- 中文 1000 字 ≈ 1500-2000 Tokens
- 英文 1000 字 ≈ 1300 Tokens
- 輸入 Token 通常比輸出 Token 便宜 3-5 倍
以 GPT-4o-mini 為例,處理一篇 3000 字的中文文章(約 5000 Tokens 輸入 + 2000 Tokens 輸出),費用大約是 $0.002,也就是不到新台幣 0.1 元。所以對大部分個人用戶來說,API 費用真的不用太擔心。
下一步行動#
如果你看完這篇文章,對 LLM 有了基本認識,接下來可以:
- 申請一個 xAI 的 API Key(免費額度最多)
- 在 n8n 裡面建立你的第一個 AI 工作流
- 嘗試不同的模型,感受差異
有任何問題,歡迎到社群裡面討論。你一定可以的,先求大概懂,再開始用,最後才能做成功!
想學更多 n8n 自動化技巧? 加入我們的 Skool 社群,和其他自動化愛好者一起學習交流!
相關資源#
- 什麼是 AI Agent?完整概念指南 - 理解 AI Agent 跟 LLM 的差異
- 5 種 AI API 完整比較 - 各家 API 的詳細設定教學
- RAG 概念完整指南 - 深入理解 RAG 增強技術
- n8n 零基礎完整教學 - 從零開始學 n8n
- n8n + Ollama 本地 LLM 教學 - 不花錢在本地跑 LLM
- YouTube: LLM 概念解析 - Alex 的 YouTube 頻道
- n8n 官方文件 - n8n AI 節點說明
✍️ 關於作者:Alex 是一位專注於 n8n 自動化和 AI 應用的技術教育者,透過 YouTube 頻道和 Skool 社群幫助超過數千位學員掌握自動化技能。